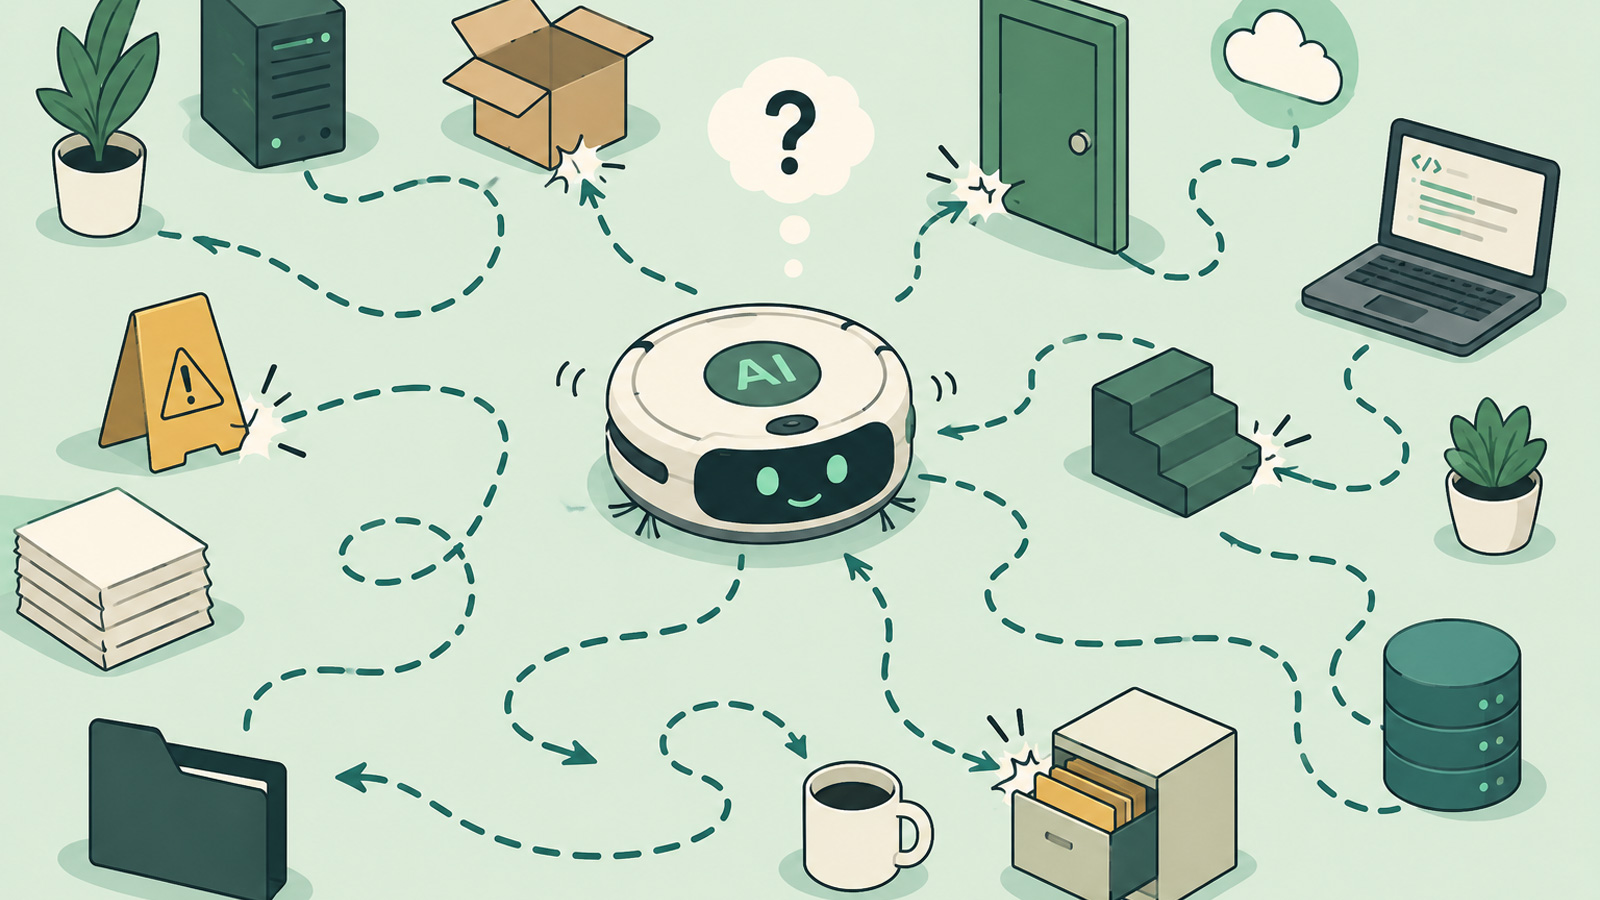
Observa a un agente de IA trabajando en una tarea y verás el futuro de la seguridad empresarial. Claude puede pasar cuatro minutos intentando leer un CSV que resulta ser una carpeta, rendirse, escribir un script para listar su contenido y finalmente lograrlo. Funciona, pero nunca como lo imaginaste. Eso es adivinar a escala, y no es un defecto: es cómo funcionan los LLMs y por qué son tan efectivos. Los agentes razonan probabilísticamente, eligen la siguiente mejor acción, observan el resultado y se adaptan. Ese bucle los hace poderosos, pero también rompe los modelos de seguridad basados en flujos de trabajo predecibles.
Las Preguntas que Nadie Quiere Responder
Cada equipo que despliega agentes se enfrenta a las mismas decisiones de acceso, a menudo sin darse cuenta: ¿Le das al agente todas las herramientas que podrían ayudar o solo las que probablemente necesitará? ¿Le otorgas autoridad de administrador porque algún caso límite podría requerirla? ¿Provisionas a los agentes con acceso amplio o lo limitas a la solicitud específica que tiene el agente ahora? Ninguna de estas tiene una respuesta clara porque aplicar el mínimo privilegio es difícil. Hacerlo para cada agente y luego para cada sesión es órdenes de magnitud más complejo. Por eso los equipos conceden acceso completo y siguen adelante.
Token Security descubre cada agente que se ejecuta en tu entorno, las identidades detrás de él y el acceso que posee cada uno.
Por qué el Manual Habitual Falla
Durante dos años, la mayoría de los esfuerzos de seguridad en IA se centraron en moldear cómo responden los modelos: filtros de prompt, restricciones de entrada y salida, y controles de comportamiento. Aunque útiles, son la capa equivocada para el problema actual. Los filtros de prompt intentan restringir el comportamiento, pero con el lenguaje natural como interfaz y un número infinito de prompts posibles, siempre hay otra vía. Un filtro que funciona el 99% del tiempo aún falla, porque el 1% de infinito sigue siendo infinito. Más importante aún, las salvaguardas operan después de que el acceso ya ha sido concedido. Una vez que un agente tiene credenciales para un sistema de producción, la frontera de seguridad ya está detrás.
La predicción también falla por la misma razón estructural. La gestión de identidades y accesos tradicional responde una pregunta: ¿a qué puede llegar esta identidad? Ese modelo es menos útil para agentes de IA. Dos agentes con permisos idénticos pueden comportarse de manera completamente diferente según lo que cada uno intente lograr. No se puede proteger un sistema impulsado por objetivos perfilando su comportamiento pasado, porque su próxima acción depende de contextos que aún no ha encontrado.
Por Qué Esto es Urgente Ahora
La escala ya ha llegado. Palo Alto Networks sitúa la proporción de identidades no humanas frente a humanas en 109 a 1, incluyendo 79 agentes de IA. Los agentes están acelerando esa curva, porque cualquiera puede crear uno en minutos, y la mayoría lo hace fuera de cualquier revisión de seguridad. Piensa en el riesgo de un agente como acceso multiplicado por autonomía. El acceso establece el radio de explosión, mientras que la autonomía reduce la ventana para la intervención humana. Las políticas IAM estáticas, escritas para humanos que inician sesión en horario laboral y se revisan trimestralmente, nunca fueron diseñadas para agentes que nunca duermen, no usan MFA y rara vez se retiran.
La Identidad es el Único Plano de Control que se Mantiene
Si eliminas el modelo, el prompt y el marco, una cosa permanece constante: cada acción que realiza un agente pasa por una identidad. Se autentica con una cuenta de servicio, una clave API, una concesión OAuth, un rol en la nube o un token. Todas las acciones, desde leer datos hasta modificar infraestructura, dependen de los permisos de las identidades del agente. Por eso la identidad, no el filtrado de prompts, es el plano de control para la IA agéntica. La identidad es la capa que abarca todos los sistemas que toca un agente, lo que la convierte en el único lugar donde puedes aplicar control de forma consistente.
La Intención es la Dimensión que Falta
El control de acceso tradicional pregunta qué puede hacer una identidad. Para los agentes, eso no es suficiente, porque el propósito es lo que separa el comportamiento seguro del peligroso. Un agente que resuelve un despliegue fallido y uno que exfiltra datos pueden realizar acciones de bajo nivel casi idénticas: leer registros, llamar APIs, acceder a una base de datos. Desde una perspectiva IAM, se ven iguales, pero su intención no es la misma. La seguridad basada en la intención añade ese contexto faltante. En lugar de preguntar '¿a qué puede acceder este agente?', preguntas '¿a qué debería poder acceder este agente para cumplir su propósito, y nada más?'.
Una vez que se define la intención, los permisos pueden limitarse estrictamente, y cualquier cosa fuera de ese límite deja de ser una anomalía rutinaria y se convierte en una señal de seguridad que vale la pena atender. Esta es también la única versión del mínimo privilegio que sobrevive al contacto con la realidad. No puedes ajustar manualmente los permisos para cada agente y cada sesión. Pero puedes modelar la intención de cada agente y aplicar automáticamente controles de acceso contra ella. Ese es el cambio que hace que el mínimo privilegio sea operativo en lugar de aspiracional.
La Visibilidad es el Mínimo Indispensable. La Aplicación es el Objetivo.
La mayoría de las herramientas se detienen en la visibilidad. Un inventario de agentes es necesario, pero no cambia lo que un agente puede hacer. Saber que tienes un problema no es lo mismo que solucionarlo, y los usuarios seguirán concediendo todo el acceso que puedan para hacer su trabajo más rápido. El trabajo que realmente reduce el riesgo es preventivo y continuo: Descubrir cada agente y las identidades que utiliza, en la nube, SaaS, endpoints y plataformas de IA, incluidos los agentes fantasma que nadie registró. Entender a qué puede acceder cada agente y qué se supone que debe hacer, para ajustar los permisos a la intención. Aplicar ese alcance automáticamente, revocar el acceso cuando un agente se retira y gobernar todo el ciclo de vida desde la creación hasta la desactivación, porque el riesgo no aparece en la creación, sino que se acumula a medida que el acceso se acumula y la propiedad se difumina.
Los agentes adivinan. Esa es su naturaleza y no va a cambiar. Lo que puedes cambiar es el radio de explosión de una adivinanza equivocada. Lo haces en la capa de identidad, con alcance según la intención, y lo aplicas antes de la acción en lugar de explicarlo después. Tus agentes seguirán improvisando. La pregunta es si improvisan dentro de límites que tú estableciste o dentro de límites que nunca dibujaste.